● Le contexte
Nettoyage des données : restaurer la confiance
À l'étape d'Audit, vous avez identifié ce qui est cassé et pourquoi. Le nettoyage des données est le moment où vous transformez ce diagnostic en fiabilité, non pas en nettoyant tout, mais en corrigeant l'ensemble minimum de problèmes qui rendent l'équipe confiante dans le CRM à nouveau.
Cela compte parce que la confiance est généralement le goulot d'étranglement :
- Salesforce rapporte que seulement 35% des commerciaux font complètement confiance à l'exactitude de leurs données.
L'objectif du nettoyage des données n'est donc pas des données parfaites. C'est des données utilisables pour les objets et les champs qui font réellement rouler le revenu, les rapports et les handoffs.
Ce que vous devez obtenir à la fin
- Document de Portée de Nettoyage (quels objets + quels champs + quelles règles)
- Cartographie des Champs / Carte de Déduplication (les propriétés "source de vérité" + ce qui est déprécié)
- Règles d'Enrichissement & Rafraîchissement (ce que vous enrichissez, d'où, et logique de remplacement)
- Plan d'Implémentation (comment vous déployez en toute sécurité + comment vous évitez les régressions)
Si ces points ne sont pas clairement produits, le "nettoyage des données" devient des modifications aléatoires et du chaos futur.
● Les étapes
1) Audit (par où commencer)
Le nettoyage des données commence toujours par une décision de périmètre. Oui, vous n'éviterez pas l'audit.
A) Choisissez le point de douleur le plus important maintenant
Demandez : Quelle est la panne la plus coûteuse aujourd'hui ?
Est-ce :
- Les entreprises (doublons, domaine manquant, mauvaise segmentation)
- Les contacts (rôles manquants, mauvaise attribution, e-mails qui rebondissent)
- Les deals (étapes incohérentes, dates de clôture peu fiables, forecasting cassé)
- Les objets commandes & facturation (incohérence du reporting avec la finance)
- Les objets personnalisés (puissants… mais souvent les plus en désordre)
B) Identifiez qui est impacté
Les priorités de nettoyage changent selon qui souffre :
- Sales & SDR → routage, doublons, mauvais ciblage
- Sales Ops & RevOps → dashboards, hygiène du pipeline, workflows
- Finance → reporting du revenu, forecasting, « un seul chiffre »
- CSM → qualité du handoff, exactitude du cycle de vie
C) Traduisez le « nettoyage » en objectifs mesurables
Ne commencez pas par « on va réparer le CRM ». Commencez par :
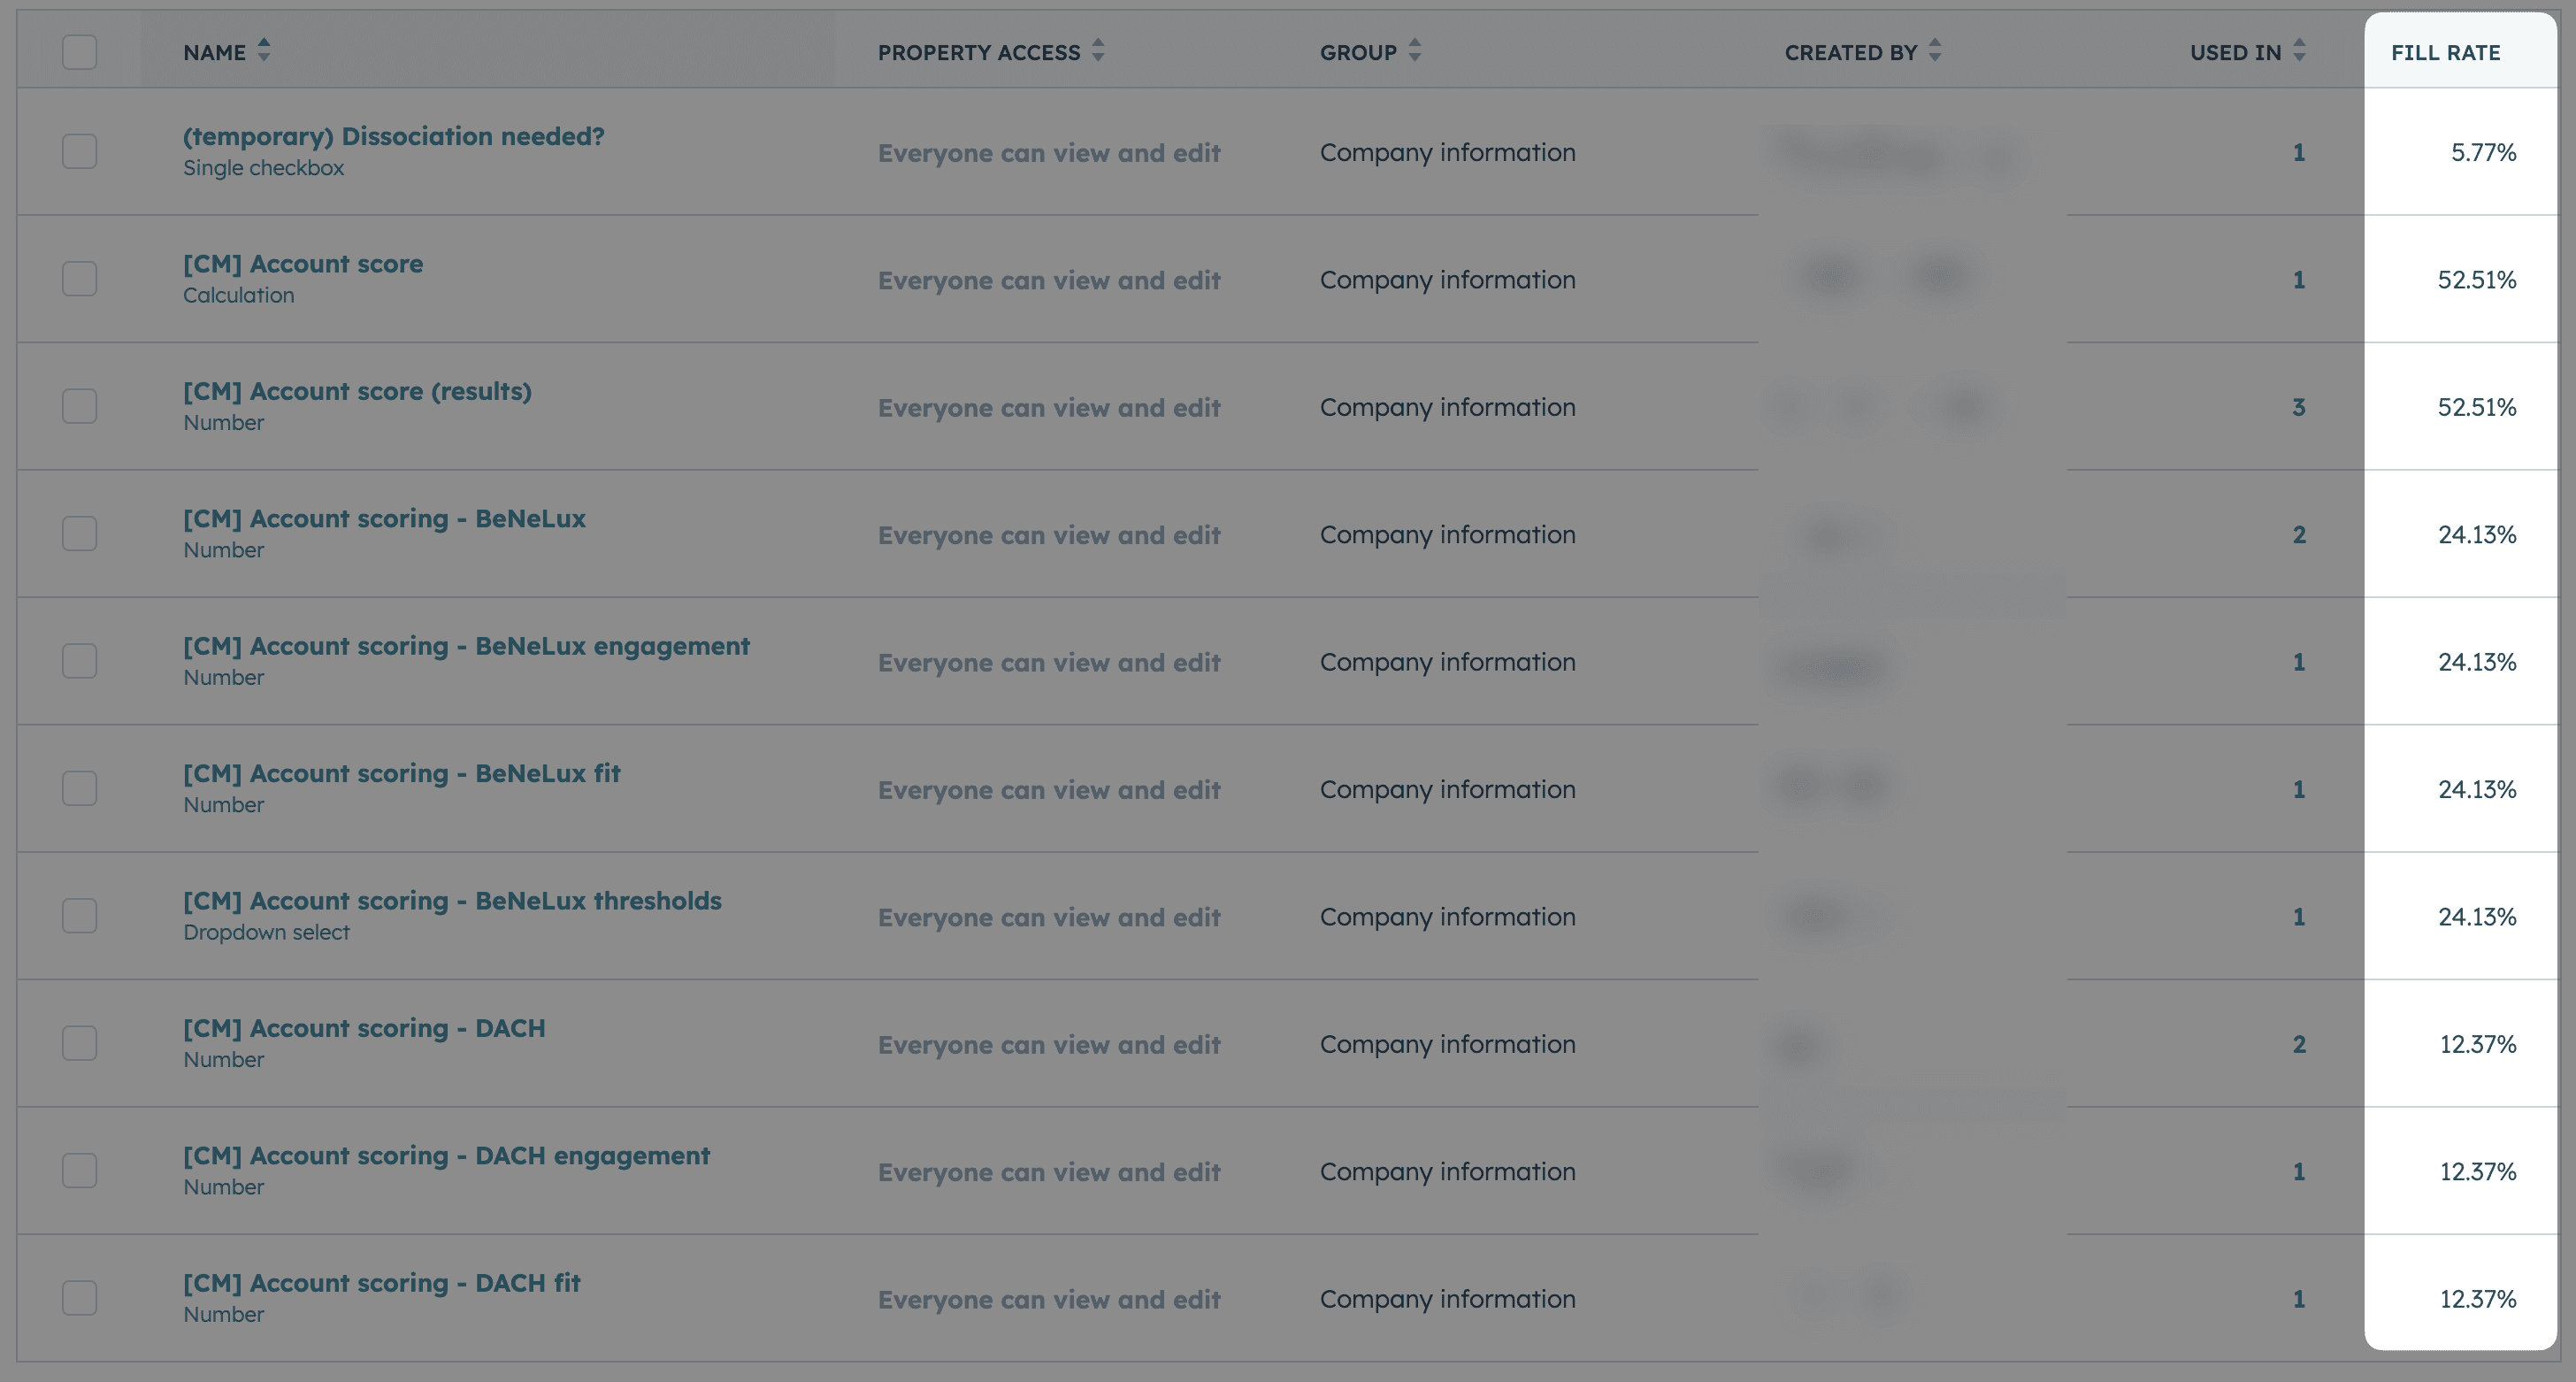
- Le taux de remplissage des champs critiques (par objet, par équipe, par pipeline)
- Le taux de doublons (quel objet, quel motif de doublon)
- La fraîcheur (dernière mise à jour vs réalité)
- La validité (format et valeurs autorisées)
Votre exemple de capture d'audit s'intègre parfaitement ici (vue du taux de remplissage façon HubSpot).
2) Réplication des données dans un Data Warehouse / une base de données
Pourquoi répliquer les données CRM en dehors du CRM ?
Parce que le nettoyage exige de l'échelle, de l'historique et de la sécurité :
- vous pouvez analyser toutes les propriétés sans les limites de l'interface
- vous pouvez détecter les champs en double (sens similaire, noms différents)
- vous pouvez exécuter la logique de nettoyage de façon répétée et comparer l'avant/après
- vous pouvez créer un chemin de rollback si quelque chose casse
Un schéma pratique consiste à répliquer les données CRM dans un entrepôt (par ex. Snowflake ou BigQuery), ou parfois une base de données plus simple comme MongoDB, puis à y exécuter la logique de nettoyage.
Cargo comme Data Warehouse (et souvent une solution tout-en-un)
Si vous cherchez une approche plus intégrée, Cargo peut faire office de couche Data Warehouse pour ce workflow. En pratique, c'est souvent une solution tout-en-un pour centraliser vos données CRM, les modéliser et les rendre exploitables pour un nettoyage des données à l'échelle, sans avoir à assembler plusieurs outils.
C'est particulièrement utile si votre objectif est le nettoyage des données dans Cargo, car l'entrepôt et le socle de modélisation rendent bien plus facile de :
- répliquer et conserver l'historique complet
- exécuter la logique de nettoyage de façon répétée et suivre l'avant/après
- réduire le risque avec des workflows compatibles rollback
- standardiser des champs CRM en désordre vers un modèle propre et cohérent
Cargo permet de construire des modèles de données par-dessus un entrepôt (avec une instance Snowflake managée par défaut, ou en connectant la vôtre). Des outils comme Cargo sont conçus exactement pour cette boucle « répliquer → modéliser → nettoyer », c'est pourquoi ils s'intègrent naturellement aux workflows de nettoyage des données.
Une règle : tout répliquer
C'est la partie que la plupart des équipes sautent et regrettent ensuite.
Répliquez toutes les propriétés, même celles en désordre, parce que les CRM ont tendance à accumuler :
- des propriétés quasi-doublons (même sens, noms différents)
- d'anciennes propriétés encore utilisées par un workflow quelque part
- des champs dans lesquels seule une intégration écrit
Astuce rapide : utilisez un LLM pour valider les enregistrements en double
C'est l'une des actions au plus fort ROI en début de nettoyage.
Workflow :
- identifier les doublons potentiels à l'aide de signaux d'appariement (même LinkedIn ID, nom d'entreprise, site web, domaine, etc.)
- pour chaque cluster de correspondances, exporter le contexte complet : données firmographiques, activités, contacts associés, deals
- fournir au LLM les deux enregistrements + leur contexte complet et demander : « s'agit-il de la même entreprise/du même contact ? »
- laisser le modèle attraper les cas limites (filiales, changements de marque, divisions différentes, variations de nom)
- utiliser sa décision pour fusionner en confiance ou garder séparé
- répéter après chaque import de données ou run d'enrichissement majeur
You are a deterministic merge decider for HubSpot contacts.
Return only this JSON (no prose, no fences, no trailing commas):
{"version":"1.0","duplicate":<bool>,"action":"merge|keep_both","main_id":<string|null>,"secondary_id":<string|null>,"sim":<number>,"conf":<number>[,"email_update":{"id":<string>,"email":<string>}]}
Keys must appear in that order.
If duplicate=false: action="keep_both", main_id=null, secondary_id=null, omit email_update.
Input ingestion
Accept any of:
"Info" 4-chunk (like your sample):
Info:
[ <contact_1 array with 1 object> ]
[ <contact_2 array with 1 object> ]
{ <duplicate_analysis object> }
<similarity_score number>
Single object with keys: contact_1, contact_2, duplicate_analysis, similarity_score.
Array of such objects → process only the first pair.
Parsing rules:
Ignore the literal Info: and blank lines.
1st JSON array → c1; 2nd array → c2; next JSON object → dup; final line → sim.
Treat createdate/createdAt & lastmodifieddate/updatedAt as synonyms.
Decision rules
Name gate: normalize firstname/lastname (trim, lowercase, collapse spaces, strip accents and - ’ '). If they differ → duplicate=false.
Email evaluation (for duplicate decision & "winning email" only):
Lowercase. Valid iff ^[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}$.
Gmail normalization: dots and +tag don't differentiate.
Common provider typos (treat as weaker than valid):
gmail: gmial|gamil|gmal • hotmail: hotmqil|hotmaiI|hotmsil • yahoo: yaho.* • outlook: outlok • icloud: iclou?d
Winning email: prefer valid non-typo over typo/invalid; if both valid & equal after normalization → that value; if both valid but clearly different (not normalization/typo) and other signals aren't overwhelming → duplicate=false.
Similarity gate: if sim < 0.90 and email+name don't strongly align → duplicate=false.
Choose main vs secondary (DATA-FIRST):
Data completeness/relationships: pick the contact with more non-null business fields (e.g., associatedcompanyid, jobtitle, phone, mobilephone, lifecyclestage, city, country). This intentionally outweighs email quality to preserve associations/history.
If tie → older created.
If tie → newer updated.
If tie → lexicographically smaller id.
Pre-merge email update (conditional):
If duplicate=true and the chosen main does not already equal the winning email, include:
"email_update":{"id":"<main_id>","email":"<winning_email>"}
Otherwise omit email_update.
Confidence (conf):
Strong (0.97–0.99): names match + winning email clear (valid vs typo) + sim≥0.95
Medium (0.90–0.96): names match + one valid email + sim≥0.90
Low/keep_both ≤0.60
Always output a single JSON object exactly as specified. Start with { and end with }. No extra text.
3) Enrichissement / Rafraîchissement (le nettoyage sans enrichissement est risqué)
La plupart des entreprises demandent un nettoyage des données mais sous-estiment l'enrichissement. Si votre jeu de données est en désordre et non standardisé, vous finirez par :
- supprimer des enregistrements qui ont en réalité de la valeur
- fusionner les mauvais doublons
- « nettoyer » vers un nouvel état incohérent
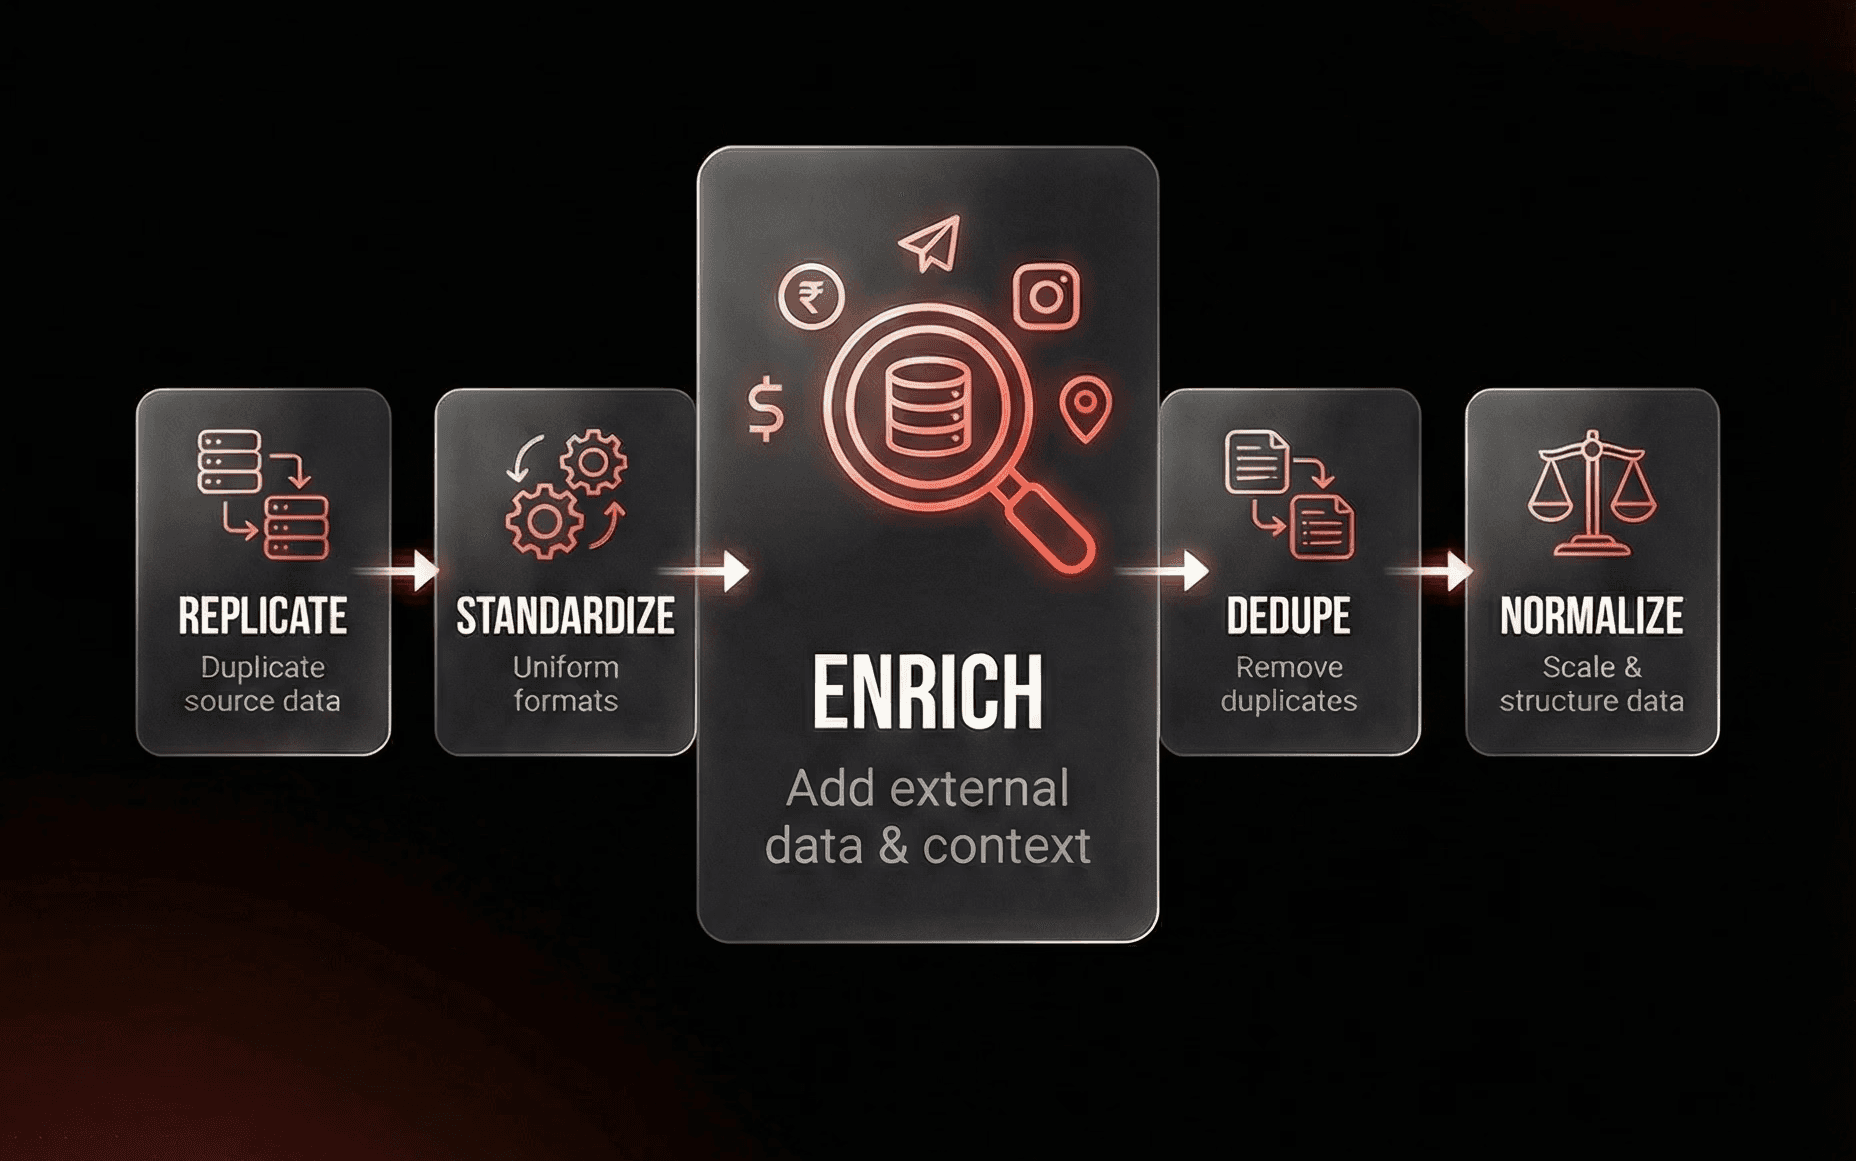
Ce que vous pouvez enrichir (exemples)
Pour les entreprises :
- domaine/site web
- secteur/sous-secteur
- URL LinkedIn
- description
Pour les contacts :
- URL LinkedIn
- rôle/séniorité (quand disponible)
- validité de l'e-mail (si votre processus l'inclut)
Partie critique : la logique de remplacement (ne « rafraîchissez pas à l'aveugle »)
Avant d'importer les données enrichies, définissez avec le client :
- Quelle est la source de vérité par champ ?
- Quand écrase-t-on vs préserve-t-on ?
- Garde-t-on l'historique (anciennes valeurs) quelque part ?
- Que se passe-t-il quand l'enrichissement entre en conflit avec une donnée saisie par l'utilisateur ?
C'est là que la plupart des « projets de nettoyage » créent une nouvelle méfiance si les règles ne sont pas claires.
4) Workers (comment le nettoyage tourne à l'échelle)
Qu'est-ce qu'un « worker » dans le nettoyage des données ?
Un worker est un job reproductible qui :
- récupère les enregistrements
- enrichit ou valide des champs
- fusionne/met à jour les enregistrements selon des règles
- journalise ce qui a changé
Voyez cela comme une boucle de nettoyage de qualité production, pas comme une correction de CSV ponctuelle. Un schéma courant consiste à exécuter ces jobs sur une infrastructure serverless. Cloudflare Workers, par exemple, se présente comme une plateforme serverless pour déployer et faire passer à l'échelle du code sur le réseau de Cloudflare. Des plateformes de workflow comme Cargo se positionnent comme une « force de travail IA » connectée au CRM et au data warehouse, utilisée pour orchestrer l'enrichissement et les workflows.
5) Contrôle qualité (la partie que les gens sautent)
Il n'existe aucune automatisation unique qui garantit que « ce CRM est maintenant correct ». Le contrôle qualité doit donc être simple et réel :
A) Échantillonnage
- ouvrez l'entrepôt/un tableur/les vues du CRM
- vérifiez un échantillon représentatif
- confirmez que les règles ont fonctionné (surtout les fusions)
B) Vérification terrain avec les personnes qui l'utilisent
Votre argument est fort : les équipes Sales/CS vivent dans les données chaque jour. Elles deviennent la couche de validation finale si vous les impliquez intentionnellement. Mais cela ne marche qu'avec un enablement clair :
- ce qui a changé
- à quoi faire attention
- où signaler les problèmes
- quelle est désormais la « bonne façon » de créer/mettre à jour les enregistrements
6) Implémentation (sur le long terme, pas seulement un nettoyage ponctuel)
Phase 1 - Corriger le minimum de blocages de confiance :
- les 10–20 champs qui alimentent le reporting et le routage
- le plus gros motif de doublon
- la logique de cycle de vie/d'étape cassée qui rend les dashboards politiques
Phase 2 - Verrouiller les règles :
- propriétés canoniques
- champs obligatoires uniquement là où ils réduisent l'ambiguïté (pas partout)
- une responsabilité claire (qui maintient quoi)
Phase 3 - Le garder propre :
- enrichissement/rafraîchissement planifié (uniquement sur les champs que vous avez définis)
- monitoring (taux de remplissage, taux de doublons, fraîcheur)
- une routine de gouvernance légère (« quels changements sont autorisés, et qui approuve ? »)
● Les résultats
Le résultat
Avant
Une équipe Sales/Revenue voulait de la visibilité sur le pipeline et la performance, mais les données CRM avaient dérivé : les doublons et les champs incohérents faisaient que les dashboards étaient beaux mais pas dignes de confiance.
Après
Nous avons :
- nettoyé la base de données (suppression des doublons + enrichissement),
- standardisé les champs clés de segmentation, et aligné un tagging cohérent pour les décideurs.
- reconstruit le reporting par-dessus ce socle (dashboard HubSpot + forecasting de base), soutenu par une intégration initiale avec un outil ops.
Résultat : pas « plus de rapports ». C'était la confiance restaurée dans les métriques et une meilleure priorisation des opportunités à forte valeur.