Résultat
pays couverts
Résultat
fiches courtiers extraites des registres gouvernementaux officiels
Résultat
scores de priorité sur chaque fiche
● Contexte
Le problème : on ne peut pas vendre sur un marché qu'on n'a pas cartographié
SantéVet est un MGA (Managing General Agent) français spécialisé dans l'assurance pour animaux de compagnie. Avec un objectif ambitieux : faire passer le chiffre d'affaires B2B de 11 % à 30 % d'ici 2028. Leur go-to-market repose sur des courtiers en assurance à travers l'Europe qui distribuent les produits SantéVet aux clients finaux.
Le défi était structurel : SantéVet n'avait aucune base de données fiable et complète de son marché cible. Leur CRM Salesforce contenait des données fragmentées, quelques courtiers français, des contacts européens épars, mais rien à partir de quoi une équipe commerciale pouvait réellement construire un pipeline.
Et leur marché cible est l'un des plus difficiles à cartographier en B2B : des intermédiaires en assurance réglementés répartis sur cinq pays européens, chacun régi par son propre registre national, avec son propre format de données, ses catégories de licence et ses méthodes d'accès. Aucun fournisseur de données B2B commercial, ni Apollo, ni ZoomInfo, ni Kaspr, ne couvre ce segment avec la profondeur ou la précision dont SantéVet avait besoin.
C'est le problème central du TAM pour les industries réglementées : le marché existe, il est bien défini, et il est enregistré publiquement, mais il n'est dans aucune base de données commerciale. Le construire suppose d'aller directement à la source.
● La solution Cashmyrr
Pourquoi la construction du TAM précède toute prospection
Avant qu'une séquence ne soit enrôlée, avant qu'un SDR n'envoie un premier e-mail, le commercial doit savoir qui existe, où ils sont, et comment les prioriser. Sans TAM structuré, les équipes gaspillent du temps de prospection sur des comptes peu pertinents ou passent à côté de segments de marché entiers dont elles ignoraient l'existence.
Pour SantéVet, opérant sur cinq marchés européens avec trois mouvements de prospection distincts (automatisation à fort volume, séquences structurées pour le mid-market, et vente enterprise à fort contact), un TAM propre et scoré n'était pas un confort. C'était le prérequis de tout le reste.
C'est aussi pourquoi le TAM arrive à un moment précis du cycle d'optimisation CRM : après la mise en place de l'infrastructure de nettoyage et d'enrichissement des données, et avant le lancement de la génération de leads. Un TAM construit par-dessus un CRM en désordre crée plus de problèmes qu'il n'en résout.
Périmètre : trois segments sur cinq marchés
Nous avons défini le TAM sur trois segments commerciaux distincts :
Marchés cibles : France, Espagne, Allemagne, Belgique et Italie. Cinq pays, cinq organismes de régulation, cinq architectures de données différentes.
La stratégie de sources de données : aller directement aux registres gouvernementaux
Le socle du TAM SantéVet, ce sont les données réglementaires officielles. Pour chaque pays, nous avons identifié le registre faisant autorité pour les intermédiaires en assurance agréés :
Chaque registre expose des champs différents, utilise des taxonomies de catégories de licence différentes, et fournit les données via des méthodes d'accès différentes, certains via des exports structurés, d'autres via des interfaces web paginées. C'est précisément pour cela que les fournisseurs de données commerciaux ne couvrent pas ce segment avec précision : la complexité de l'harmonisation de cinq systèmes réglementaires distincts n'est pas économiquement viable à l'échelle pour une base de données B2B horizontale.
Pour SantéVet, c'était la seule voie fiable.
● Étapes
Le pipeline complet
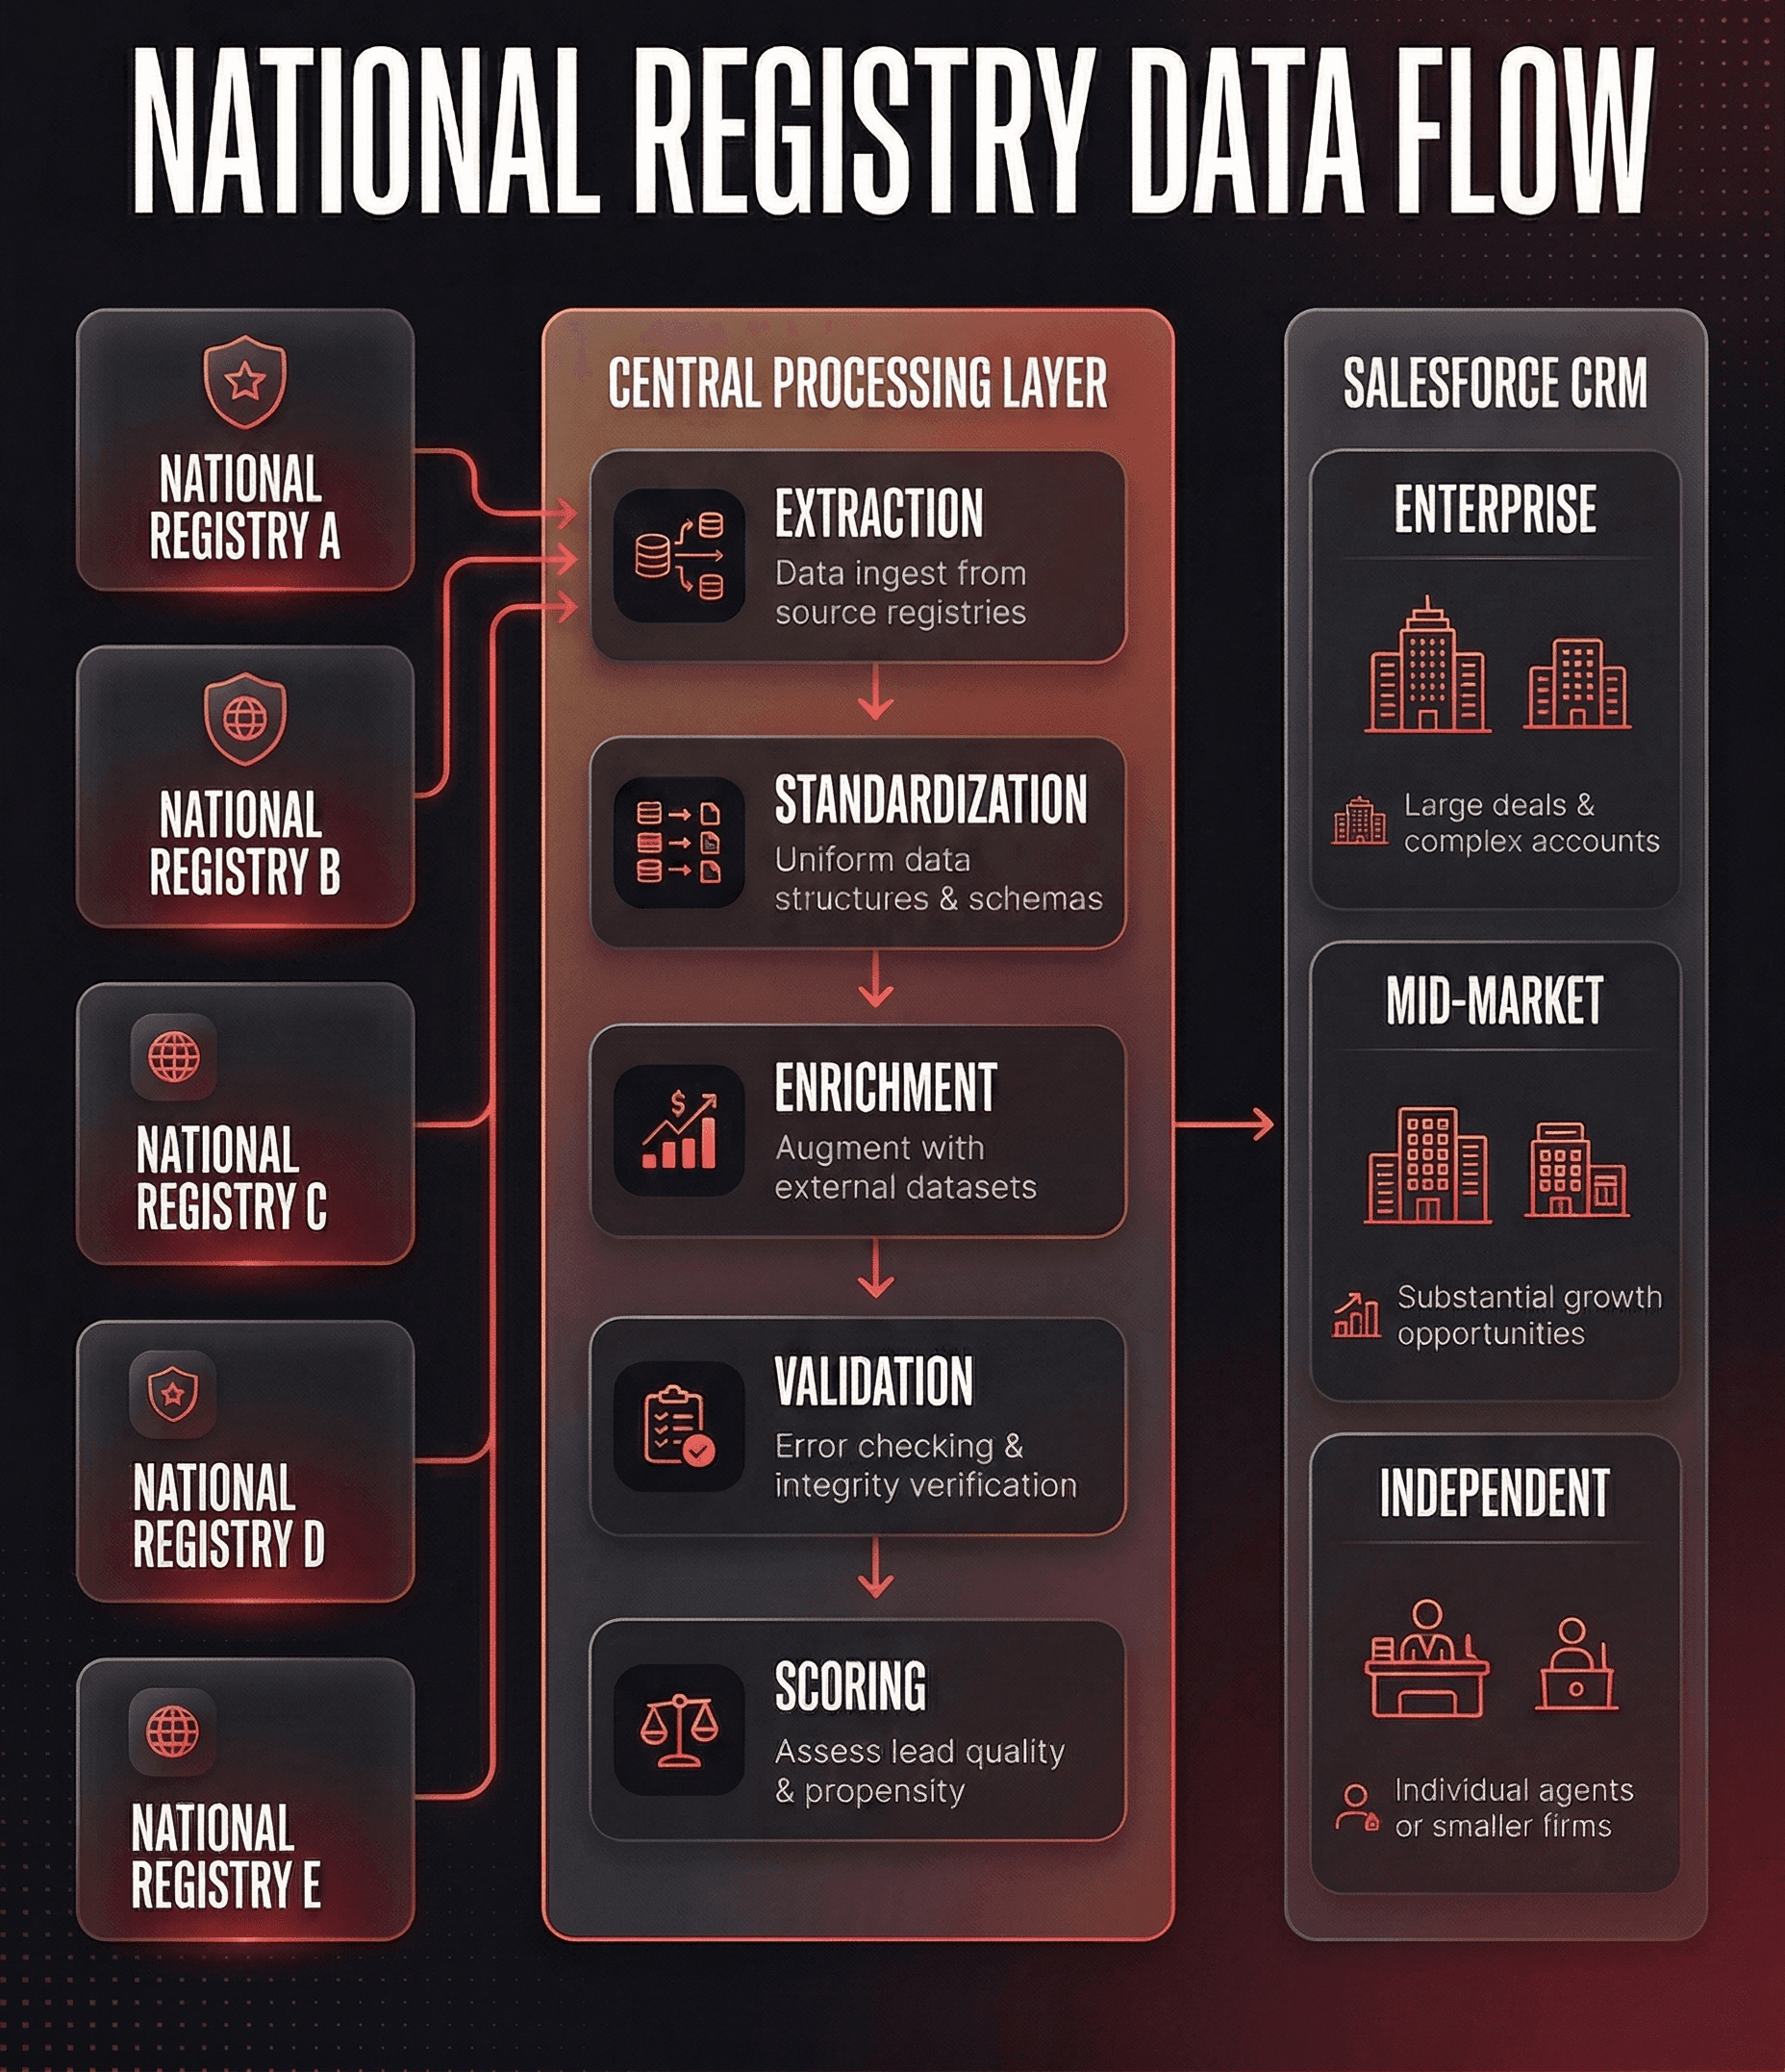
Étape 1 : Extraction
Nous avons écrit des scripts Python sur mesure pour chaque registre national, gérant la logique d'extraction spécifique à chaque source de données : pagination, limitation de débit, normalisation des formats de données, et gestion des erreurs pour les fiches incomplètes.
Résultat : cinq jeux de données bruts avec leurs champs et structures natifs.
Étape 2 : Standardisation
Les données brutes des registres ne sont pas prêtes pour le CRM. Les noms d'entreprise sont formatés de manière incohérente. Les catégories de licence utilisent des conventions de nommage différentes selon les pays. Les statuts d'enregistrement sont encodés différemment.
Nous avons construit une couche de standardisation qui a normalisé toutes les fiches dans un schéma unifié : format de nom d'entreprise cohérent, catégories de licence mappées d'un pays à l'autre (ex. « Courtier en assurance » en France, « Corredor de seguros » en Espagne : même rôle, libellé différent), statuts d'enregistrement validés, et licences inactives ou suspendues signalées avant même d'atteindre le CRM.
Étape 3 : Enrichissement
Les données des registres vous donnent la licence. Elles ne vous donnent pas de site web, d'e-mail, d'effectif, ni aucun des contextes commerciaux nécessaires pour qualifier et prioriser un compte.
Nous avons mené un processus d'enrichissement multicouche :
- Requêtes SERP pour faire remonter les sites web et profils sociaux des entreprises
- Parsing de sites web propulsé par LLM pour extraire les descriptions d'activité, les spécialités, les signaux de taille d'équipe et les coordonnées
- Booléens de validation sectorielle pour confirmer la pertinence vis-à-vis de l'ICP de SantéVet (capacité de distribution d'assurance pour animaux, courtiers multi-branches vs agents mono-produit)
- Extraction et validation des e-mails pour la disponibilité à la prospection
- Nombre d'avis et signaux d'empreinte numérique comme indicateurs indirects de la taille du cabinet et de sa présence sur le marché
Étape 4 : Validation ligne par ligne
L'enrichissement en masse produit toujours des cas limites : des filiales mal catégorisées comme courtiers indépendants, des holdings avec plusieurs entités enregistrées, des licences inactives non signalées au stade de l'extraction, et des erreurs de classification sectorielle aux marges.
Nous avons mené une passe de validation fiche par fiche pour les comptes prioritaires, spécifiquement les segments enterprise et mid-market où la précision de la qualification affecte directement le temps des AE. La longue traîne des ~50 000 courtiers indépendants a été validée via des règles automatisées et des contrôles par échantillon.
Étape 5 : Scoring
Chaque fiche a reçu un score de priorité pré-calculé de 1 à 100, construit à partir d'une combinaison de :
- Type et périmètre de licence (multi-branches vs mono-produit)
- Signaux de taille du cabinet (effectif, empreinte numérique, nombre d'avis)
- Proximité géographique avec les canaux de distribution les plus forts de SantéVet
- Potentiel estimé de distribution d'assurance pour animaux basé sur la spécialité
Cela signifie que les SDR de SantéVet peuvent trier n'importe quel segment par score et commencer immédiatement par les comptes prioritaires, sans tri manuel.
Étape 6 : Import dans le CRM
Les données ont été livrées dans une structure prête pour Salesforce avec :
- Documentation du mapping des champs pour chaque objet (Account, Contact)
- Logique de déduplication rapprochant les fiches existantes par URL de site web et nom d'entreprise
- Tags de segment pour un routage immédiat vers le bon mouvement de prospection
- Champ de score de priorité pré-rempli pour le tri et le filtrage
Le processus de validation
Nous n'avons pas tout livré d'un coup. Le processus a suivi un modèle de validation par étapes :
- Lot d'échantillon (200-300 fiches par pays) livré à l'équipe de SantéVet pour contrôle qualité
- Tour de feedback : corrections sur les classifications sectorielles, ajustements de périmètre, traitement des cas limites
- Lot plus large livré avec les corrections appliquées
- Validation finale du client avant la livraison complète
Cette approche itérative compte parce que l'équipe du client comprend son marché mieux que n'importe quel fournisseur de données externe. Un courtier qui semble valide d'après les données du registre peut être un cas connu comme sans intérêt sur le marché, l'équipe du client repère ces cas en revue.
● Résultat
Ce que SantéVet a obtenu
Du TAM au revenu : la suite
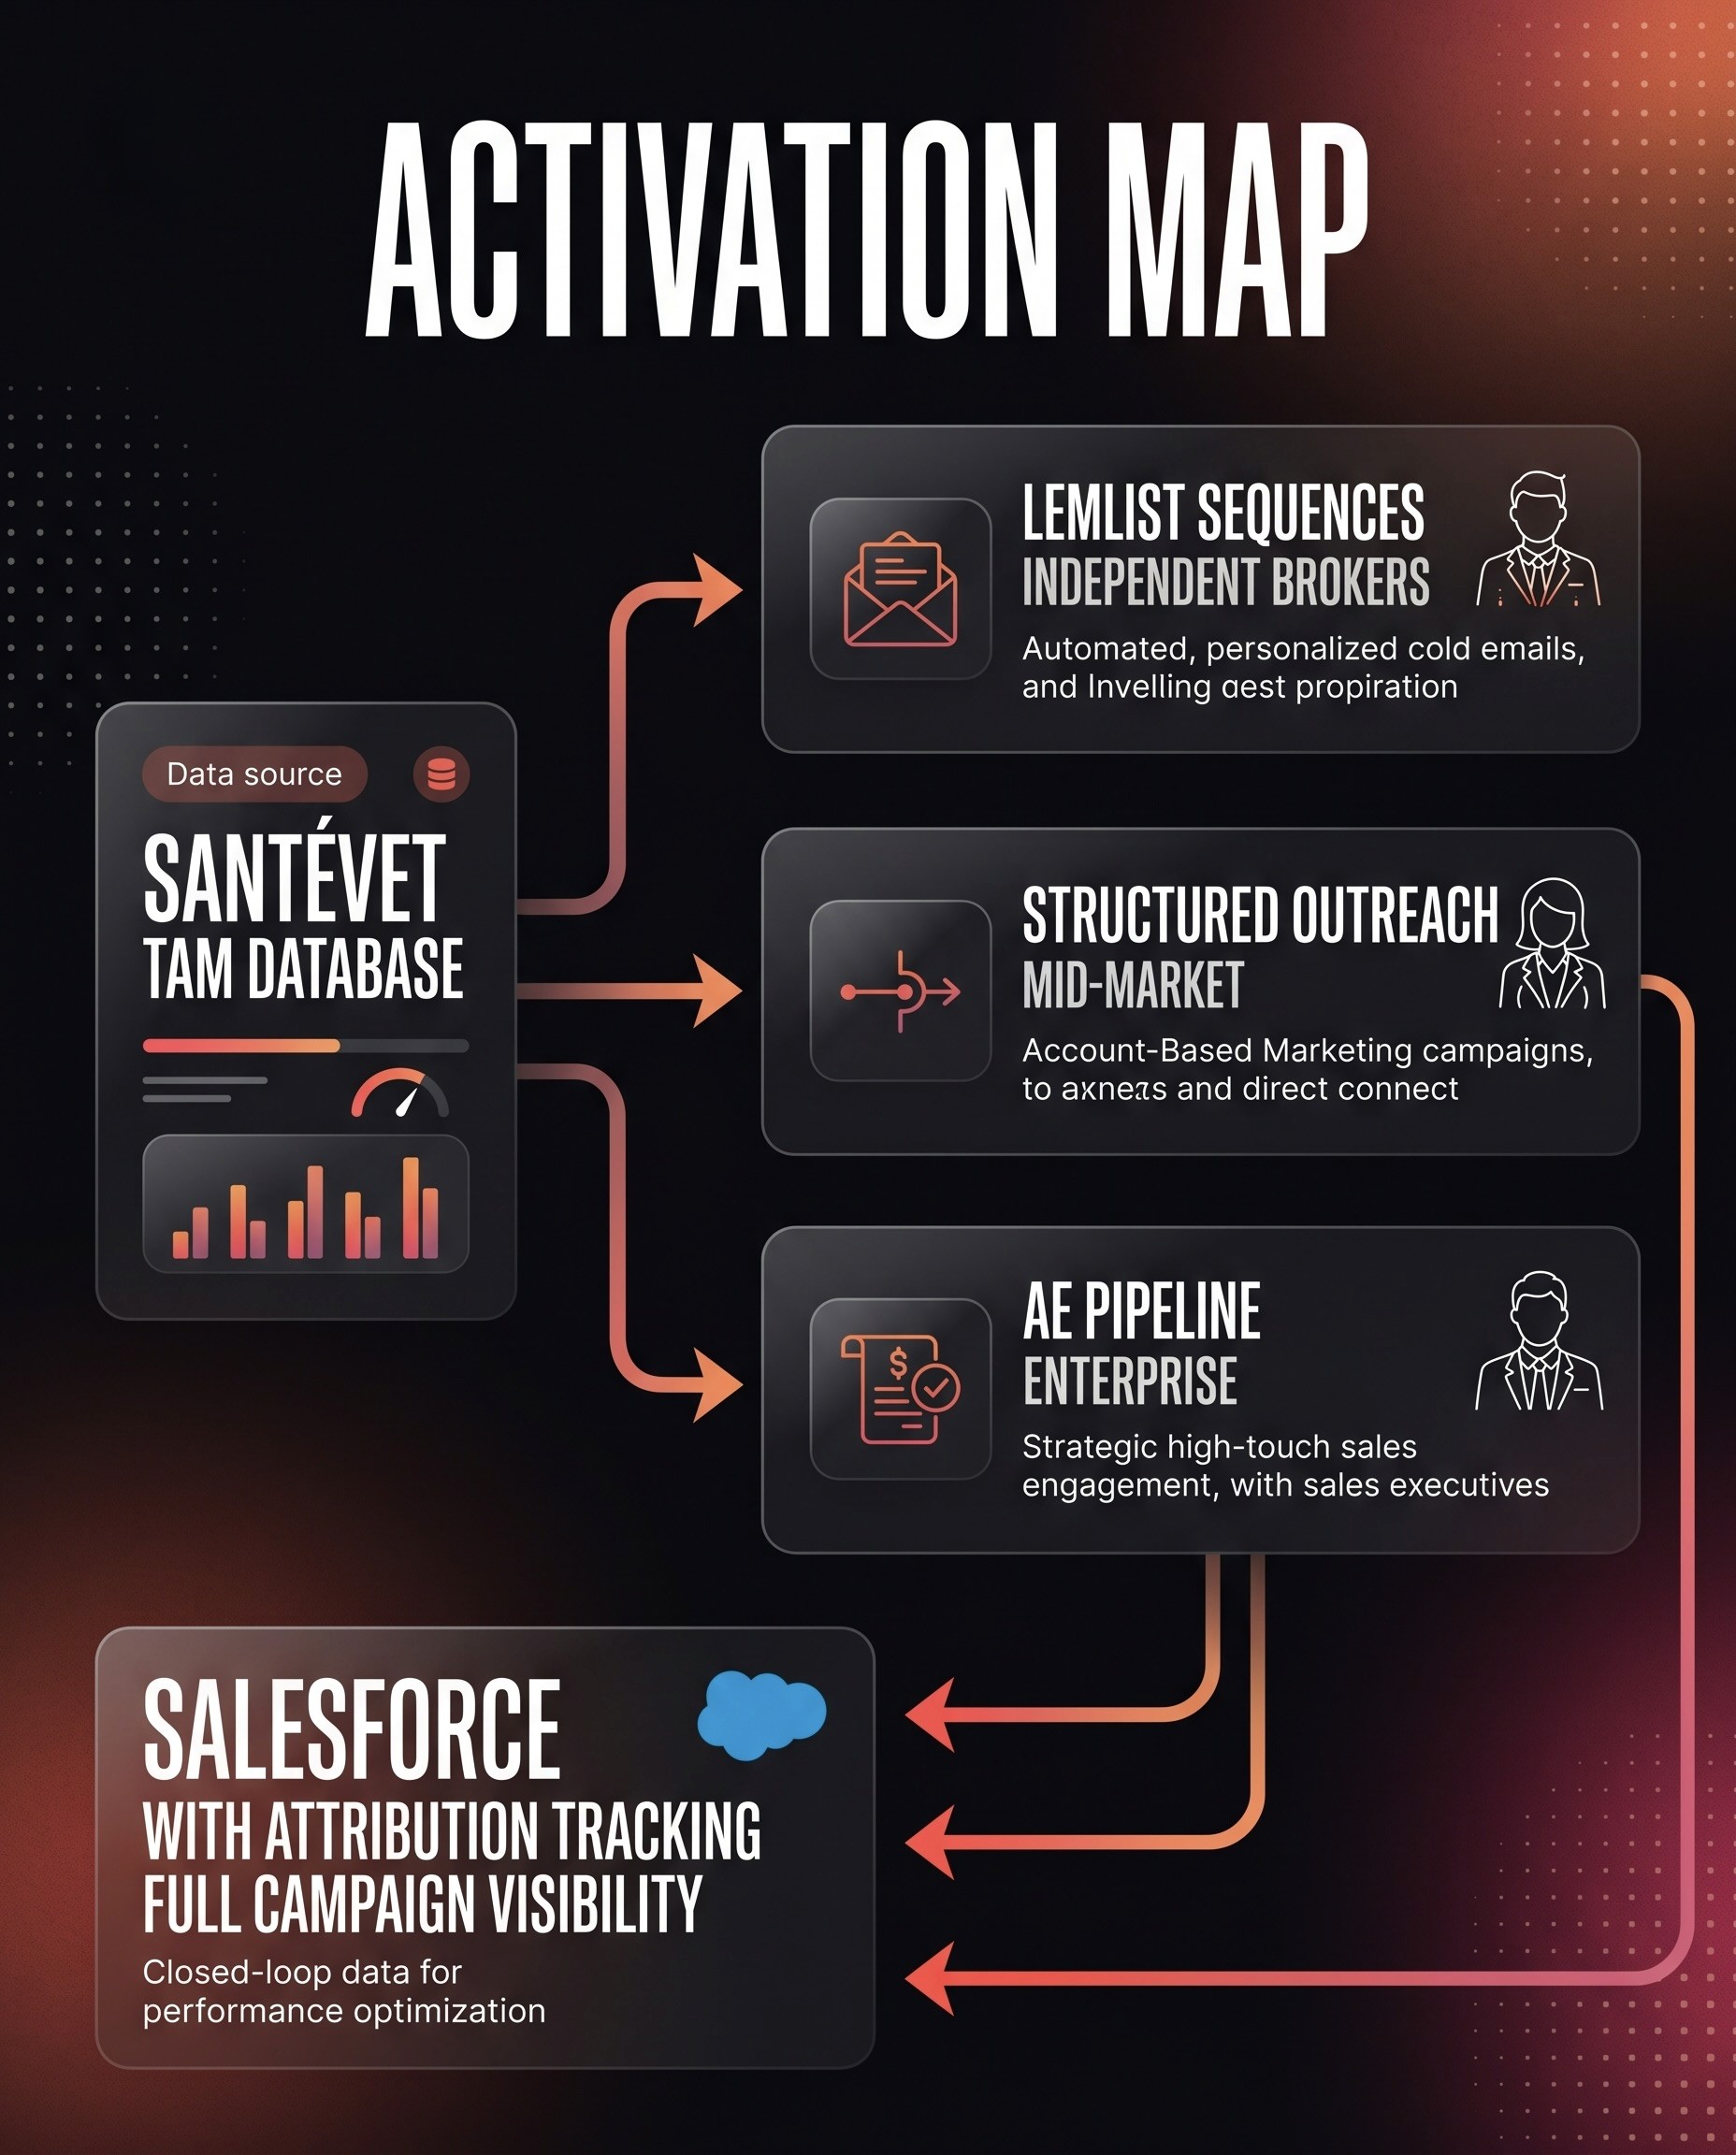
Une base TAM n'a de valeur que connectée à un mouvement de prospection activé. Pour SantéVet, la structure en trois tiers correspond directement à trois plays go-to-market distincts :
- ~50 000 courtiers indépendants → enrôlés dans des séquences Lemlist automatisées, à faible contact, à fort volume, optimisées pour la délivrabilité à l'échelle
- ~500 cabinets mid-market → prospection multi-étapes structurée avec personnalisation basée sur les données d'enrichissement (spécialité, taille d'équipe, géographie)
- 100-150 comptes enterprise → vente à fort contact façon ABM, chaque compte recherché individuellement, plusieurs interlocuteurs cartographiés, coordination entre AE et management
Le modèle de scoring garantit qu'à l'intérieur de chaque tier, les commerciaux commencent toujours par les comptes les plus prioritaires, pas par les premiers dans l'ordre alphabétique.
La feuille de route de SantéVet inclut aussi d'autres pays européens. Parce que la méthodologie est documentée : source du registre, logique d'extraction, schéma de standardisation, couche d'enrichissement, modèle de scoring, la réplication pour un nouveau marché est un exercice d'exécution, pas un projet de recherche.
● Questions fréquentes
Les bases de données B2B commerciales sont conçues pour la scalabilité sur des segments horizontaux (entreprises tech, services professionnels, SaaS). Les verticaux réglementés, intermédiaires en assurance, conseillers financiers, santé, exigent des données au niveau de la licence que les fournisseurs commerciaux ne capturent pas avec précision. Le statut d'enregistrement, le type de licence et la spécialité ne sont disponibles de façon fiable qu'auprès de l'organisme de régulation officiel. Toute base de données commerciale s'appuyant sur des sources secondaires présentera des lacunes importantes et des fiches obsolètes sur ces segments.
Pour cinq pays à ce périmètre (~51 000 fiches + enrichissement), le cycle complet de l'extraction à la livraison prête pour Salesforce prend 4 à 8 semaines selon la qualité des données à la source et le nombre de tours de validation nécessaires. Les TAM mono-pays peuvent être livrés nettement plus vite.
Une liste de prospection est un export à plat de contacts qui correspondent à un filtre grossier. Un TAM est une base de données structurée, scorée et segmentée qui cartographie l'intégralité de votre marché adressable, pas seulement la portion facile à trouver. La distinction compte sur le plan opérationnel : un TAM vous dit quelle part du marché vous avez couverte, quels segments restent inexploités, et où allouer les ressources commerciales sur tout l'horizon du pipeline.
Nous construisons la logique de déduplication avant l'import, en rapprochant les nouvelles fiches des données CRM existantes via une combinaison de l'URL du site web, du nom d'entreprise (normalisé), et du numéro d'enregistrement lorsqu'il est disponible. Les correspondances ambiguës sont signalées pour revue manuelle plutôt que fusionnées automatiquement, car des fusions incorrectes sont plus difficiles à corriger que des doublons non résolus.
Oui. L'approche centrale, identifier le registre réglementaire faisant autorité par marché, extraire les données structurées, standardiser entre juridictions, et enrichir avec du contexte commercial, s'applique à toute industrie réglementée dotée d'organismes de licence nationaux. L'effort varie selon l'accessibilité du registre et la qualité des données par pays.
● Voir d'autres case studies